NKTg AI for Organizers | NKTg
RAG giúp AI truy xuất thông tin liên quan. NKTg AI tiếp cận theo một hướng khác: phân tích cấu trúc ngữ nghĩa, xác định các luận điểm cốt lõi, phân biệt hành động với điều kiện và bảo toàn các câu nguyên văn trước khi chuyển thông tin đến mô hình ngôn ngữ lớn (LLM).
Sự khác biệt nằm ở bản chất: RAG tập trung tìm kiếm thông tin liên quan. NKTg AI tập trung xác định chính xác nội dung mà thông tin thực sự khẳng định.
1. Hai cách tiếp cận khác nhau trong xử lý thông tin
RAG — Truy xuất thông tin tăng cường sinh nội dung
RAG thường sử dụng Embedding và Vector Search để tìm kiếm các đoạn tài liệu dựa trên mức độ tương đồng ngữ nghĩa.
Quy trình:
Tài liệu → Chia đoạn (Chunking) → Embedding → Vector Search → Truy xuất ngữ cảnh → LLM → Câu trả lời.
Phương pháp này hiệu quả khi tìm kiếm trong các kho dữ liệu lớn. Tuy nhiên, độ tương đồng ngữ nghĩa không đồng nghĩa với mức độ quan trọng về mặt logic.
Ví dụ, một nghĩa vụ thanh toán trong hợp đồng và điều kiện làm phát sinh nghĩa vụ đó có thể cùng liên quan đến thanh toán, nhưng chúng đảm nhiệm những chức năng ngữ nghĩa hoàn toàn khác nhau.
NKTg AI — Phân tích cấu trúc ngữ nghĩa
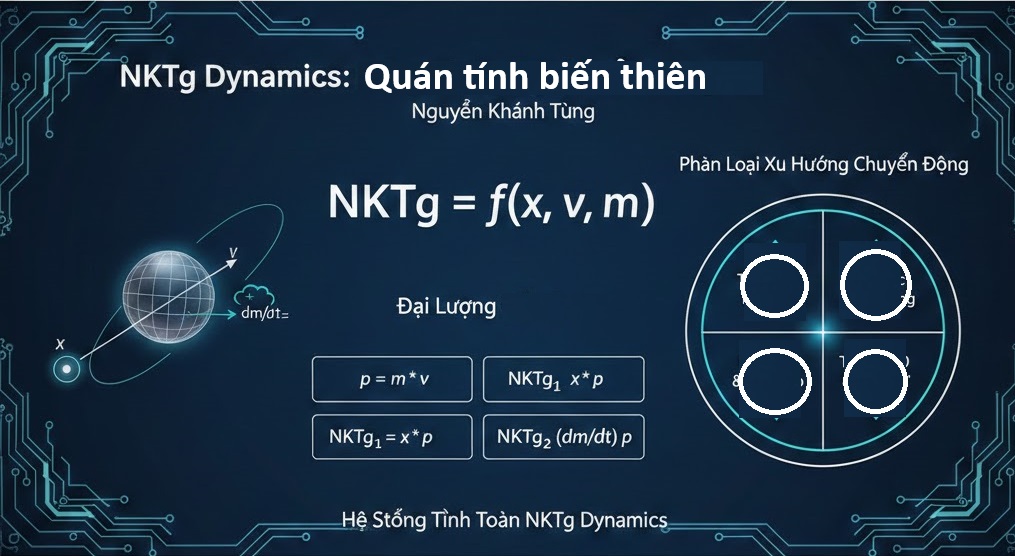
NKTg AI đưa ra một khung xử lý khác, dựa trên NKTg Law và toán tử quán tính biến thiên.
Mô hình khái niệm:
NKTg = f(x, v, m)
p = m × v
NKTg₁ = x × p (Năng lượng thế ngữ nghĩa)
NKTg₂ = (dm/dt) × p (Năng lượng động ngữ nghĩa)
Hệ thống tổ chức thông tin thành ba nhóm:
- AMP (Action – Meaning – Proposition): Các hành động, khẳng định và kết quả cụ thể.
- DAMP (Dynamic/Dependent Meaning): Các điều kiện, yếu tố phụ thuộc, ngoại lệ và rủi ro.
- STABLE: Thông tin và dữ liệu có tính ổn định.
Nguyên tắc phân bổ:
AMP% + DAMP% + STABLE% = 100%.
Khi AMP vượt ngưỡng 55%, NKTg AI nhận diện văn bản có trọng tâm hành động nổi trội và kích hoạt cơ chế trích xuất Core Content.
Core Content là những câu nguyên văn được xác định có mật độ hành động cao và ý nghĩa ngữ nghĩa cụ thể theo tiêu chí của hệ thống.
2. Kiến trúc xử lý LLM theo một hướng tiếp cận khác
RAG truyền thống truy xuất thông tin, sau đó dựa vào LLM để thực hiện các bước diễn giải và suy luận tiếp theo.
NKTg AI đưa vào một tầng xử lý ngữ nghĩa chuyên biệt trước khi sinh nội dung.
Kiến trúc NKTg AI:
Văn bản nguồn → Phân tích ngữ nghĩa → Phân loại AMP/DAMP/STABLE → Core Content → Cấu trúc thông tin → LLM → Kết quả.
NKTg AI đảm nhận việc phân tích ngữ nghĩa và tổ chức thông tin. LLM đảm nhận việc sinh ngôn ngữ, tóm tắt và trình bày câu trả lời.
Sự phân tách này hướng đến mục tiêu giảm thông tin nhiễu, bảo toàn các câu từ nguồn gốc và tăng khả năng kiểm soát dữ liệu đầu vào của LLM.
3. Một hướng tiếp cận khác trong kiểm soát ảo giác AI
RAG giảm nguy cơ ảo giác bằng cách cung cấp cho LLM thông tin được truy xuất từ các nguồn dữ liệu.
Tuy nhiên, việc bỏ sót điều kiện, phân mảnh ngữ cảnh, truy xuất đoạn văn không phù hợp hoặc tổng hợp sai thông tin vẫn có thể ảnh hưởng đến kết quả cuối cùng.
NKTg AI tiếp cận vấn đề ngay tại tầng xử lý thông tin.
Thông qua việc nhận diện hành động, điều kiện, ngoại lệ và các câu nguyên văn trước khi sinh nội dung, hệ thống hướng đến việc cung cấp cho LLM một cấu trúc thông tin rõ ràng và có khả năng truy xuất, kiểm chứng.
Không có kiến trúc nào có thể bảo đảm loại bỏ hoàn toàn hiện tượng ảo giác AI. NKTg AI hướng đến việc làm cho quá trình xử lý ngữ nghĩa trở nên minh bạch, có cấu trúc và có thể kiểm soát tốt hơn.
4. Hai công nghệ, hai trọng tâm khác nhau
| RAG | NKTg AI |
|---|---|
| Truy xuất thông tin | Phân tích cấu trúc ngữ nghĩa |
| Embedding và Vector Search | NKTg Law |
| Xử lý các đoạn tài liệu | Xử lý câu và cấu trúc ngữ nghĩa |
| Xếp hạng độ liên quan | Phân loại ngữ nghĩa |
| Tìm kiếm đoạn thông tin phù hợp | Xác định các luận điểm cốt lõi |
| Phụ thuộc vào LLM trong diễn giải | Xử lý thông tin trước khi sinh nội dung |
| Tìm kiếm tri thức quy mô lớn | Phân tích chuyên sâu từng văn bản |
RAG phù hợp với các ứng dụng như kho tri thức doanh nghiệp, tìm kiếm trên nhiều tài liệu và khai thác thông tin.
NKTg AI hướng đến những ứng dụng đòi hỏi phân tích tài liệu có cấu trúc, bao gồm hợp đồng, báo cáo tài chính, nghiên cứu khoa học, nghĩa vụ, điều kiện và ngoại lệ.
5. Vượt ra ngoài sự cạnh tranh: Cơ hội tích hợp công nghệ
RAG và NKTg AI không nhất thiết phải hoạt động độc lập.
Một kiến trúc kết hợp có thể sử dụng RAG để tìm kiếm tài liệu liên quan, sau đó sử dụng NKTg AI để phân tích cấu trúc ngữ nghĩa trước khi chuyển thông tin đến LLM.
Truy xuất thông tin → NKTg phân tích ngữ nghĩa → Phân loại AMP/DAMP/STABLE → Core Content → LLM → Câu trả lời.
Cách tiếp cận này kết hợp khả năng tìm kiếm thông tin quy mô lớn với năng lực xử lý ngữ nghĩa chuyên biệt.
Kết luận: Hướng đến trí tuệ ngữ nghĩa có cấu trúc
Giai đoạn phát triển tiếp theo của AI không chỉ phụ thuộc vào khả năng truy xuất nhiều thông tin hơn, mà còn phụ thuộc vào cách thông tin được phân tích, tổ chức, bảo toàn và kiểm chứng trước khi trở thành kết quả do AI tạo ra.
RAG tạo nền tảng kết nối LLM với các nguồn tri thức bên ngoài.
NKTg AI khai thác một hướng phát triển bổ sung: xây dựng một tầng trí tuệ ngữ nghĩa chuyên biệt giữa thông tin nguồn và AI tạo sinh.
NKTg AI — Trí tuệ ngữ nghĩa. Hiểu biết có cấu trúc. Kiểm soát tốt hơn quá trình tạo sinh AI.
Website: https://nktg.org/