Bạn đã bao giờ nhờ AI tóm tắt một hợp đồng quan trọng, đọc kết quả gật gù đồng ý — rồi thấp thoáng một cảm giác: “Ừ mà… đâu chắc nó tóm tắt đúng chỗ quan trọng?”
Vấn đề đó không phải do model yếu. Mà do bản chất kiến trúc: mọi LLM ngày nay đều đọc xong rồi diễn giải lại bằng ngôn ngữ của chính nó. Xác suất thống kê + sinh token = luôn tồn tại rủi ro bịa, méo, hoặc nhấn sai trọng tâm. Với văn bản thường thì chẳng sao. Với hợp đồng, báo cáo kiểm toán, tài liệu nghiên cứu — nơi một chữ “không” đổi chỗ là đổi cả nghĩa — thì đó là rủi ro không chấp nhận được.
Đó là lý do tôi phát triển NKTg AI — và triết lý của nó ngược hoàn toàn với hướng đi của giới AI hiện tại:
Không sinh ra nội dung mới. Chỉ đo lường nội dung đã tồn tại.
🧠 Core Content — “mã di truyền” của một văn bản
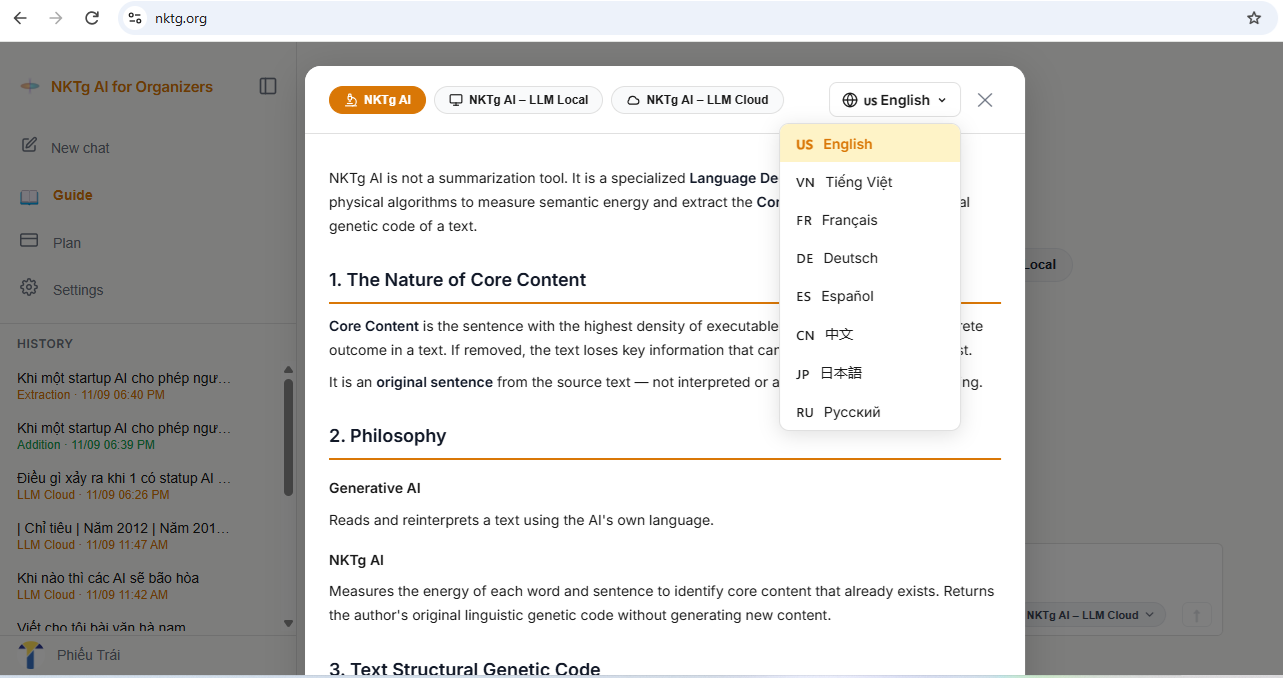
NKTg AI không tóm tắt. Nó giải mã. Mỗi văn bản được phân tích theo mô hình năng lượng ngữ nghĩa:
- AMP (Amplifying) — năng lượng tăng: hành động, khẳng định, thực thi, kết quả
- DAMP (Damping) — năng lượng giảm: điều kiện, ngoại lệ, rủi ro, phản biện
- STABLE — cân bằng: dữ liệu thuần, bảng biểu, mô tả
Và luôn tuân theo: AMP% + DAMP% + STABLE% = 100%.
Từ đó hệ thống trích xuất Core Content — câu nguyên văn gốc trong văn bản có mật độ hành động khả thi cao nhất và kết quả cụ thể nhất. Nguyên văn nghĩa là: không thêm, không bớt, không diễn giải. Nếu bỏ câu này đi, văn bản mất thông tin then chốt mà phần còn lại không suy ra được.
Kiểm chứng nhanh bằng chính trải nghiệm của bạn: đọc một bài báo dài, bạn thường chỉ nhớ một câu. Câu đó chính là Core Content. NKTg AI chỉ là công cụ tìm ra nó bằng thuật toán thay vì trực giác.
Còn nền tảng toán? NKTg Law — thuật toán quán tính biến thiên, lấy cảm hứng từ vật lý:
textCopy
NKTg = f(x, v, m)
p = m × v
NKTg₁ = x × p          (Năng lượng thế ngữ nghĩa)
NKTg₂ = (dm/dt) × p    (Năng lượng động ngữ nghĩa)
🏗️ Kiến trúc 2 tầng — nơi LLM chỉ được làm “cửa nối”
Phần tôi tâm đắc nhất với tư cách người làm kỹ thuật. Thay vì một model khổng lồ vừa đo vừa đoán vừa viết, NKTg AI tách hẳn hai trách nhiệm:
textCopy
Văn bản gốc → [Tầng 1: NKTg AI — bộ não giải mã] → [Tầng 2: LLM — giao diện sinh ngôn ngữ] → Kết quảTầng 1 đo năng lượng, phân rã cấu trúc, lọc nhiễu, trích Core Content — thuần thuật toán, không sinh suy đoán.
Tầng 2 — LLM — không bao giờ nhìn thấy văn bản thô. Nó chỉ nhận cấu trúc logic đã chuẩn hóa rồi chuyển thành ngôn ngữ tự nhiên.
Hệ quả rất đẹp về mặt kiến trúc: hallucination bị chặn ngay ở tầng thiết kế, chứ không phụ thuộc vào việc prompt cẩn thận hay không. Rác không vào được đầu vào thì không thể xuất hiện ở đầu ra.
🔒 Và toàn bộ hệ thống chạy trong trình duyệt của bạn
Đây là điều khiến tôi chọn WebAssembly + WebGPU từ ngày đầu:
- 📵 Văn bản không bao giờ rời thiết bị của bạn — không server, không cloud, không database từ xa. History nằm trong localStorage của chính bạn.
- ⚡ Low latency, chạy offline sau lần tải model đầu
- 💻 Với LLM Local: model chạy trực tiếp trên GPU của bạn qua WebGPU (WebLLM + model nhỏ 1–4B, quantize 4-bit, cache trong IndexedDB)
- ☁️ LLM Cloud — hoàn toàn MIỄN PHÍ cho ai không có máy cấu hình mạnh: cùng lớp giải mã NKTg AI, phần sinh ngôn ngữ chạy trên cloud, không cần tải gì về máy
Tôi tin trong 2026, “privacy” không nên là tính năng — mà phải là kiến trúc mặc định.
🎯 Dùng thật — ai cần cái này?
| Bạn là ai | NKTg AI giúp gì |
|---|---|
| 🧑⚖️ Luật, hợp đồng | Tách điều khoản ràng buộc (AMP) khỏi điều kiện ngoại lệ (DAMP) trong vài giây |
| 📊 Tài chính, kiểm toán | Đọc báo cáo dài mà dữ liệu không bao giờ bị “tạm dịch” sai |
| 🔬 Nghiên cứu, sinh viên | Tổng hợp tài liệu giữ nguyên ý tác giả — Core Content là câu gốc |
| 👨💼 Quản lý bận | Nhìn AMP/DAMP% là biết tài liệu đáng đọc kỹ hay chỉ cần lướt |
| 👨💻 Dev tò mò | Một case study thật về chạy LLM trong browser bằng WebGPU/WASM |
Limit trung thực: OCR với tài liệu viết tay hiện chưa chính xác bằng văn bản in — tôi nói rõ để bạn không kỳ vọng sai.
🚀 Thử trong 30 giây
Vào nktg.org → chọn chế độ trên toolbar (LLM Cloud là miễn phí) → dán bất kỳ đoạn văn nào bạn đang đọc dở, hoặc thả file (.txt, .docx, .xlsx, .pdf, ảnh) → nhìn AMP/DAMP% và Core Content hiện ra.