Mở đầu: cùng một nỗi đau, hai toa thuốc khác nhau
Ai từng dùng LLM cho công việc nghiêm túc — đọc hợp đồng, phân tích báo cáo tài chính, tổng hợp tài liệu nghiên cứu — đều quen một cảm giác bất an: vẫn biết là AI có thể bịa. RAG (Retrieval-Augmented Generation) ra đời để giảm nỗi bất an đó. Nhưng RAG và NKTg AI – LLM thực chất đang giải bài toán ở hai tầng khác nhau, bằng hai triết lý đối nghịch. Bài này phân tích căn bản để bạn tự quyết định cái nào phù hợp với việc của mình — hoặc dùng cả hai.
1. Bản chất thuật toán: đo “giống nhau” hay đo “quan trọng”?
RAG truyền thống — Vector Search & Embeddings:
- Dựa trên xác suất thống kê và độ tương đồng không gian (cosine similarity)
- Cơ chế: chia tài liệu thành chunks → nhúng vector → tìm các đoạn “gần nghĩa” với câu hỏi → ném vào context window cho LLM tự đọc
- Giới hạn cốt lõi: similarity chỉ đo được “đoạn nào giống câu hỏi”, không đo được đoạn nào thực sự quan trọng trong logic của văn bản. Câu chứa trọng tâm hành động và câu điều kiện rườm rà có thể “tương đồng” như nhau
NKTg AI — NKTg Law:
- Dựa trên thuật toán vật lý, toán tử quán tính biến thiên:
textCopy
NKTg = f(x, v, m)
p    = m × v
NKTg₁ = x × p          (Năng lượng thế ngữ nghĩa)
NKTg₂ = (dm/dt) × p (Năng lượng động ngữ nghĩa)- Đo năng lượng ngữ nghĩa từng câu: AMP (hành động, khẳng định, kết quả) / DAMP (điều kiện, ngoại lệ, rủi ro) / STABLE (dữ liệu thuần). Luôn tuân theo AMP% + DAMP% + STABLE% = 100%
- Khi AMP > 55%, văn bản có trọng tâm rõ ràng và câu Core Content — câu nguyên văn có mật độ hành động cao nhất, kết quả cụ thể nhất — được trích xuất chính xác
Nói ngắn: RAG trả lời “văn bản nào giống câu hỏi?”. NKTg AI trả lời “văn bản này đang khẳng định gì, với điều kiện nào?”.
2. Tầng trung gian: “gom tài liệu” hay “giải mã ADN”?
RAG: không có bộ não giải mã chuyên biệt. Nó nhặt (Retrieve) các đoạn văn thô rồi ném (Augment) trực tiếp cho LLM đọc. Toàn bộ việc đọc hiểu, phân loại thông tin — hành động hay điều kiện, khẳng định hay rủi ro — đều phó mặc cho LLM tự suy luận trong một lượt forward pass.
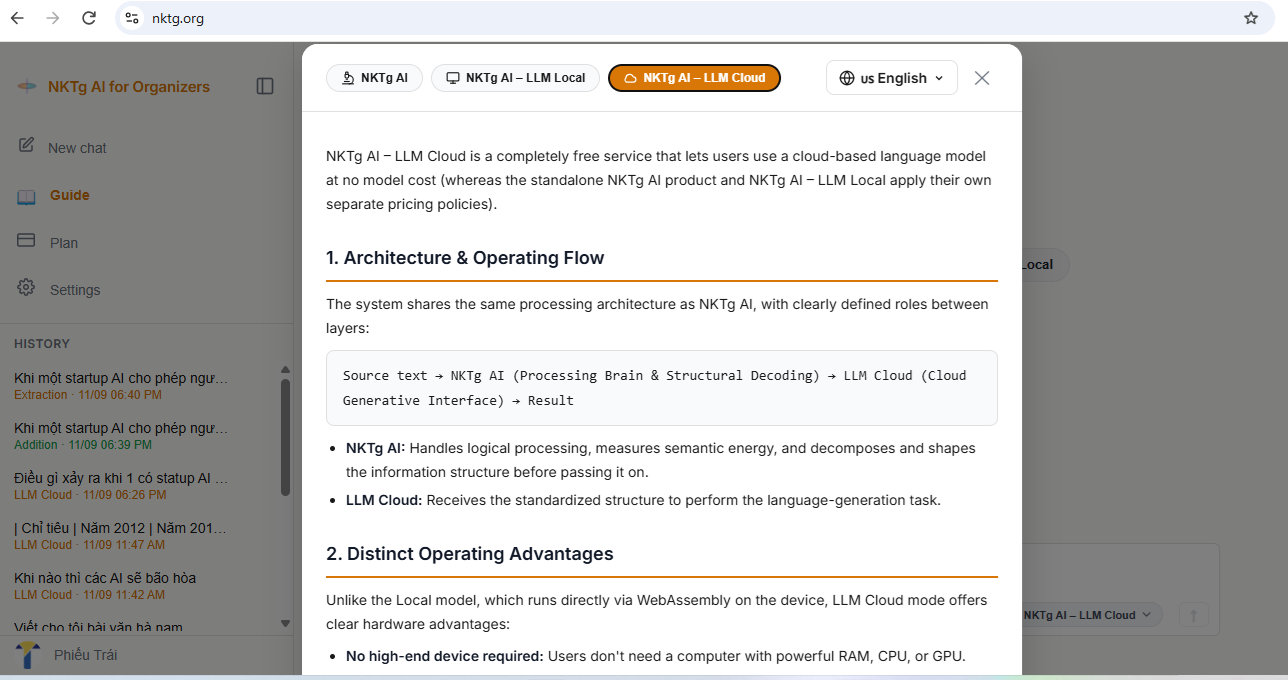
NKTg AI – LLM: NKTg AI là bộ não xử lý logic & định lượng đứng độc lập trước LLM:
textCopy
Văn bản thô → [NKTg AI: giải mã cấu trúc, chuẩn hóa, trích Core Content]
           → [Kết quả đã kiểm chứng]
           → [LLM: chỉ sinh ngôn ngữ từ khung logic đó]
LLM (Local hoặc Cloud) không bao giờ nhìn thấy văn bản thô và không tự suy luận trên dữ liệu thô — nó chỉ là giao diện sinh ngôn ngữ (Generative Interface), diễn đạt lại khung logic đã có.
Một cách công bằng cần nói thêm: RAG hiện đại đã có re-ranking, structured retrieval, GraphRAG… Nhưng khác biệt căn bản vẫn nguyên vẹn: đầu ra của tầng trung gian trong RAG là danh sách chunks thô xếp theo độ liên quan; trong NKTg AI là kết quả phân tích có kiểm chứng, giữ nguyên câu gốc.
3. Cơ chế kiểm soát ảo giác: giảm xác suất hay chặn ở kiến trúc?
RAG: giảm ảo giác một cách xác suất — chunks đúng nhiều thì LLM ít bịa hơn. Nhưng rủi ro vẫn tồn tại: chunks truy xuất dài lê thê chứa nhiễu, hoặc LLM “sáng tác” thêm khi tổng hợp từ context window.
NKTg AI – LLM: kiểm soát ảo giác ở tầng kiến trúc, bằng cơ chế lọc 2 lớp:
- NKTg AI cô lập hoàn toàn thành phần rủi ro/nhiễu (DAMP) khỏi câu hành động gốc, trả về dữ liệu nguyên bản, chưa qua diễn giải chủ quan
- LLM chỉ được nhận dữ liệu đã qua kiểm chứng này — rác không vào được đầu vào thì không thể xuất hiện ở đầu ra
Cần nói trung thực: độ trung thực của cả hệ thống bị chặn trên bởi độ chính xác của tầng giải mã, chứ không phải “100% tuyệt đối” như một số mô tả quảng ba vẫn nói. Nhưng đó chính là điểm mạnh của kiến trúc này: sai (nếu có) nằm ở tầng đo lường — kiểm chứng được, debug được — thay vì nằm trong sự “hiểu nhầm” tối của một mô hình xác suất.
4. Bảng so sánh tổng hợp
| Tiêu chí | RAG truyền thống | NKTg AI – LLM |
|---|---|---|
| Cơ sở xử lý | Biểu diễn vector & độ tương đồng xác suất | Năng lượng ngữ nghĩa & toán tử vật lý (NKTg Law) |
| Câu hỏi nó trả lời | “Đoạn nào giống câu hỏi?” | “Văn bản này khẳng định gì, điều kiện nào?” |
| Xử lý ngữ cảnh | Đưa toàn bộ chunks tìm được vào LLM | Phân tách AMP (hành động) và DAMP (điều kiện/rủi ro), trích Core Content |
| Vai trò LLM | Đọc, phân tích, suy luận và viết câu trả lời | Chỉ là giao diện sinh ngôn ngữ từ khung logic có sẵn |
| Tính nguyên bản | LLM có thể diễn giải lại, lệch ý tác giả | Giữ nguyên “mã gen ngôn ngữ” gốc — câu trọng tâm là câu nguyên văn |
| Kiểm soát ảo giác | Giảm xác suất (tùy chất lượng truy xuất) | Chặn ở kiến trúc (LLM không có dữ liệu thô để mà bịa) |
| Đơn vị xử lý | Chunk (cắt máy) | Câu nguyên văn |
| Thực thi | Thường cần Vector DB + LLM Cloud | LLM Local chạy 100% trong trình duyệt (WebAssembly), văn bản không rời thiết bị |
| Phạm vi | Kho tri thức lớn, nhiều tài liệu | Một văn bản cần trung thực tuyệt đối |
5. Ẩn dụ để nhớ mãi
- RAG giống như gom một xấp tài liệu liên quan đưa cho thư ký tự đọc rồi tóm tắt — thư ký giỏi thì tốt, nhưng thư ký vẫn có thể hiểu nhầm hoặc nói quá.
- NKTg AI – LLM giống như dùng máy quét chuyên dụng lọc ra đúng ADN cốt lõi của tài liệu trước, rồi mới giao cho thư ký — việc của thư ký giờ chỉ là viên man lại thành câu văn hoàn chỉnh, chứ không phải tự hiểu tài liệu.
6. Vậy nên dùng cái nào?
Đây không phải bài “A thay thế B”. Hai kiến trúc giải hai vấn đề khác nhau và xếp chồng được nhau:
- Cần hỏi đáp trên kho tri thức lớn (ngàn tài liệu, kiến thức bên ngoài văn bản) → RAG là công cụ đúng
- Cần trung thực tuyệt đối với một văn bản cụ thể (hợp đồng, báo cáo kiểm toán, tài liệu pháp lý/nghiên cứu) → NKTg AI – LLM sinh ra cho việc này
- Và trong tương lai gần nhất: tầng giải mã của NKTg AI hoàn toàn có thể ngồi trước một pipeline RAG — làm bước phân tích cấu trúc thay cho chunking mù quáng.
Thử trực tiếp tại nktg.org — dán một đoạn hợp đồng hoặc báo cáo dài, nhìn AMP/DAMP% và Core Content trước khi quyết định có đọc kỹ cả văn bản hay không. Chế độ LLM Cloud miễn phí, còn LLM Local thì văn bản của bạn không bao giờ rời khỏi thiết bị.