Trong kỷ nguyên AI tạo sinh, bất kỳ ai sử dụng Mô hình Ngôn ngữ Lớn (LLM) cho các công việc đòi hỏi độ chính xác tuyệt đối như pháp lý, tài chính, hay nghiên cứu khoa học đều phải đối mặt với một thách thức tử huyệt: Hiện tượng ảo giác (hallucination) của AI.
Một điều khoản hợp đồng bị suy diễn sai lệch, một con số trong báo cáo tài chính bị đặt sai ngữ cảnh, một điều kiện ngoại lệ bị bỏ qua, hay một kết luận khoa học bị AI tự ý bịa thêm ý mà tác giả chưa từng viết — đây không đơn thuần là lỗi diễn đạt, mà là sự suy giảm nghiêm trọng tính toàn vẹn của thông tin.
Các giải pháp truyền thống như RAG (Retrieval-Augmented Generation) được phát triển nhằm giảm thiểu vấn đề này bằng cách truy xuất tài liệu liên quan từ kho dữ liệu. Tuy nhiên, việc đưa cho LLM các đoạn văn bản thô có liên quan chưa đủ để bảo đảm AI hiểu đúng bản chất và không tự suy diễn.
NKTg AI tiếp cận bài toán từ một hướng hoàn toàn khác: Triệt tiêu nguy cơ ảo giác ngay từ kiến trúc đầu vào nhờ tầng giải mã cấu trúc và năng lượng ngữ nghĩa chuyên biệt.
1. Khác biệt từ bản chất: Tìm kiếm sự tương đồng hay Đo lường Năng lượng Ngữ nghĩa?
RAG truyền thống: Đặt cược vào độ tương đồng vector (Similarity)
RAG vận hành dựa trên kỹ thuật Embedding và Vector Search (thường dùng Cosine Similarity):
- Chia tài liệu thành các đoạn nhỏ (Chunks).
- Biến đổi các Chunks và câu hỏi của người dùng thành vector ngữ nghĩa.
- Tìm kiếm các Chunks có độ tương đồng cao nhất và đẩy vào ngữ cảnh (Context Window) cho LLM xử lý.
Giới hạn cốt lõi của RAG: Độ tương đồng ngữ nghĩa không đồng nghĩa với vai trò logic. Một câu chứa nghĩa vụ hành động chính và một câu chứa điều kiện ngoại lệ/rủi ro có thể có độ tương đồng vector giống hệt nhau khi truy xuất. RAG tìm được thông tin liên quan, nhưng đẩy toàn bộ gánh nặng phân tích cấu trúc logic cho LLM. Nếu LLM suy luận sai giữa hai câu này, ảo giác và sự lệch lạc thông tin lập tức xuất hiện.
NKTg AI: Định lượng năng lượng và giải mã cấu trúc ngữ nghĩa
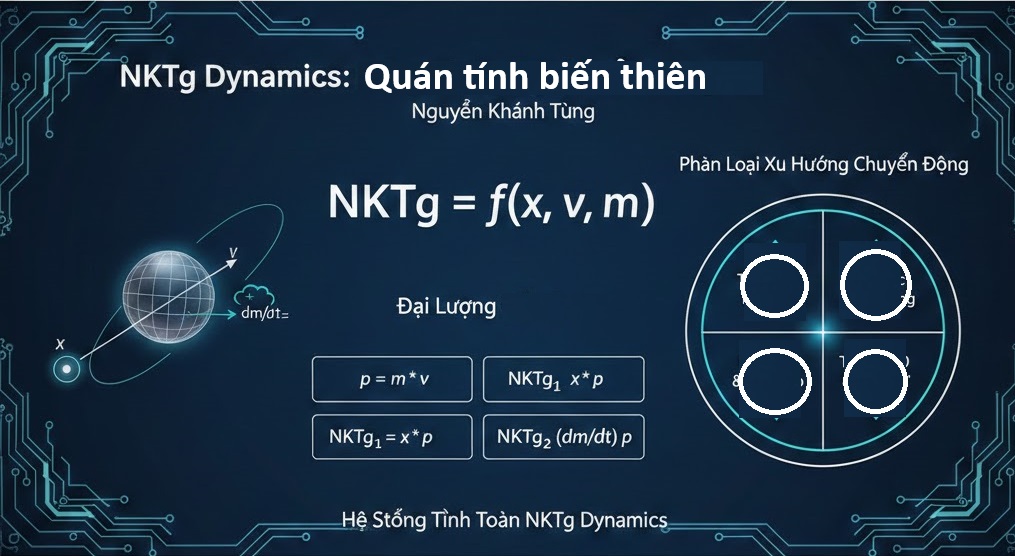
NKTg AI không đo độ tương đồng mà áp dụng mô hình định lượng NKTg Law (Định luật Quán tính biến thiên NKTg) dựa trên các toán tử vật lý ngữ nghĩa:
$$\text{NKTg} = f(x, v, m)$$
$$p = m \times v$$
$$\text{NKTg}_1 = x \times p \quad (\text{Năng lượng thế ngữ nghĩa})$$
$$\text{NKTg}_2 = \left(\frac{dm}{dt}\right) \times p \quad (\text{Năng lượng động ngữ nghĩa})$$
Hệ thống đo lường và phân loại chính xác từng câu trong văn bản thành ba nhóm thành phần với tổng định lượng khép kín:
$$\text{AMP%} + \text{DAMP%} + \text{STABLE%} = 100%$$
- AMP (Action – Meaning – Proposition): Nhóm nội dung hành động, khẳng định, triển khai và kết quả thực thi. Khi $\text{AMP} > 55%$, hệ thống xác định văn bản có trọng tâm hành động nổi trội và tiến hành trích xuất Core Content (Câu trọng tâm).
- DAMP (Dynamic / Dependent Meaning): Nhóm nội dung điều kiện, ngoại lệ, ngữ cảnh phụ thuộc, rủi ro và rào cản.
- STABLE: Nhóm dữ liệu thuần túy, thông tin kỹ thuật ổn định.
Sự khác biệt: RAG hỏi “Đoạn văn nào có ý nghĩa gần với câu hỏi nhất?”. NKTg AI hỏi “Văn bản đang khẳng định điều gì, hành động nào là trọng tâm (AMP) và điều kiện nào chi phối hành động đó (DAMP)?”.
2. Kiến trúc tầng trung gian: Đưa tài liệu thô cho AI đọc hay Giải mã cấu trúc trước?
Sự khác biệt lớn nhất giữa RAG và NKTg AI nằm ở cách phân công nhiệm vụ cho LLM trong pipeline xử lý dữ liệu.
MÔ HÌNH RAG TRUYỀN THỐNG:
Văn bản thô ──> Chunking ──> Embedding ──> Vector Search ──> LLM (Đọc + Phân tích + Suy luận + Trả lời)
Trong kiến trúc RAG, LLM phải tự gánh toàn bộ quá trình đọc hiểu, phân biệt thông tin chính – phụ và suy luận logic từ các Chunks thô. Đây chính là vùng không gian phát sinh ảo giác.
MÔ HÌNH NKTg AI – LLM:
Văn bản nguyên bản
       │
       ▼
┌──────────────────────────────────────────┐
│                 NKTg AI                  │
│  • Phân tích cấu trúc ngữ nghĩa           │
│  • Định lượng AMP / DAMP / STABLE        │
│  • Trích xuất Core Content nguyên văn    │
└──────────────────────────────────────────┘
       │ (Khung thông tin đã giải mã & chuẩn hóa)
       ▼
┌──────────────────────────────────────────┐
│                LLM Local                 │
│      (Generative Interface / Visual)     │
│  • Diễn đạt ngôn ngữ tự nhiên             │
│  • Trình bày kết quả minh bạch           │
└──────────────────────────────────────────┘
Trong kiến trúc này, NKTg AI đóng vai trò Bộ não xử lý logic & cấu trúc (Processing Brain), còn LLM đóng vai trò Giao diện tạo sinh ngôn ngữ (Generative Interface). LLM không còn phải đọc và tự diễn giải văn bản thô từ đầu, mà chỉ nhận khung thông tin đã được NKTg AI đo lường, bóc tách và chuẩn hóa logic.
3. Khả năng Kiểm soát Ảo giác: NKTg AI không ảo giác nhờ Kiến trúc Đầu vào Bảo toàn Nguyên bản
Nhiều giải pháp cố gắng “chữa cháy” hiện tượng ảo giác của LLM ở tầng sau (dùng prompt engineering, re-ranking hay bộ lọc câu trả lời). NKTg AI xử lý tận gốc bài toán ảo giác ngay từ tầng giải mã kiến trúc đầu vào:
- Khóa chặt tính nguyên bản (Original Core Content Preservation): NKTg AI bóc tách và giữ nguyên các câu cốt lõi từ văn bản nguồn mà không cho phép AI tự ý diễn giải, tóm tắt lại hoặc sáng tác thêm từ ngữ.
- Loại bỏ hoàn toàn không gian tự suy diễn (Zero-Inference Hallucination): LLM không nhận được các văn bản thô nhiễu loạn để tự do “đoán ý tác giả”. Khung dữ liệu truyền sang LLM đã được định lượng rõ ràng: đâu là khẳng định chính (AMP), đâu là rào cản/ngoại lệ (DAMP).
- Phân tách hoàn toàn nhiệm vụ Xử lý Logic và Tạo sinh: Đa số ảo giác xảy ra khi LLM vừa phải đóng vai “chuyên gia phân tích logic” vừa đóng vai “nhà sáng tác ngôn ngữ”. Bằng cách chuyển giao 100% nhiệm vụ phân tích logic cho tầng thuật toán vật lý NKTg AI, LLM chỉ tập trung chuyển đổi cấu trúc đó thành câu trả lời tự nhiên.
- Khả năng minh bạch và truy nguyên tuyệt đối (Traceability): Khi người dùng hoặc chuyên gia cần kiểm chứng, hệ thống có thể chỉ rõ chính xác tỷ lệ AMP/DAMP và câu nguyên bản nào được chọn làm Core Content. Mọi câu trả lời đều có thể kiểm tra ngược lại nguồn gốc mà không phải tin vào một “hộp đen” xác suất.
4. Bảng So sánh Tổng thể: RAG truyền thống vs. NKTg AI
| Tiêu chí | RAG truyền thống | NKTg AI – LLM Architecture |
|---|---|---|
| Triết lý thiết kế | Truy xuất các đoạn thông tin có liên quan | Giải mã cấu trúc và năng lượng ngữ nghĩa |
| Cơ sở thuật toán | Vector Embeddings, Cosine Similarity | NKTg Law, Toán tử quán tính biến thiên |
| Đơn vị xử lý | Đoạn văn bản (Chunk) | Câu nguyên bản và Cấu trúc ngữ nghĩa |
| Xử lý Hành động & Điều kiện | Phụ thuộc hoàn toàn vào khả năng đọc của LLM | Phân loại định lượng rõ ràng thành AMP và DAMP |
| Kiểm soát Ảo giác | Giảm nguy cơ dựa trên ngữ cảnh được cung cấp (vẫn có rủi ro bịa ý) | Khóa chặt ảo giác từ tầng giải mã, bảo toàn câu nguyên văn |
| Vai trò của LLM | Đọc thô, tự phân tích, suy luận và sinh câu trả lời | Đóng vai trò Generative Interface (diễn đạt khung thông tin đã xử lý) |
| Tính nguyên bản | Dễ bị LLM biến tấu, diễn giải lệch ngữ cảnh gốc | Bảo tồn nguyên bản mã gen logic của tác giả |
| Môi trường thực thi | Cần hệ thống cloud server & vector search phức tạp | Chạy trực tiếp trên browser via WebAssembly/WebGPU (LLM Local) bảo mật tuyệt đối |
5. Phép so sánh trực quan
Hãy tưởng tượng bạn cần phân tích nghĩa vụ thanh toán trong một hợp đồng dài 100 trang:
- Phương pháp RAG: Tìm tất cả các trang có từ khóa “thanh toán”, gom thành một xấp tài liệu rồi đưa cho một người đọc tự tổng hợp. Người này vẫn phải tự căng mắt phân biệt đâu là điều khoản chính, đâu là điều kiện phạt, và rủi ro bị đọc sót hoặc hiểu sai điều kiện kèm theo là rất cao.
- Phương pháp NKTg AI: Trước khi chuyển tài liệu cho người đọc, tầng giải mã NKTg AI rà soát toàn bộ hợp đồng bằng thuật toán vật lý:
- Đâu là câu mang năng lượng hành động/nghĩa vụ chính? (AMP)
- Đâu là câu chứa điều kiện nghiệm thu, ngoại lệ, miễn trừ trách nhiệm? (DAMP)
- Đâu là câu trọng tâm mang tính quyết định? (Core Content)
NKTg AI đóng đóng khung chính xác cấu trúc logic nguyên bản này rồi mới chuyển cho LLM trình bày. Người dùng nhận được kết quả chính xác, đúng trọng tâm và hoàn toàn không bị sai lệch hay hư cấu.
6. Cộng hưởng Kiến trúc: NKTg AI là Tầng Giải Mã Ngữ Nghĩa Cho RAG
NKTg AI và RAG không nhất thiết phải loại trừ lẫn nhau. Trong các hệ thống enterprise xử lý hàng triệu tài liệu, NKTg AI chính là tầng giải mã lý tưởng tích hợp vào RAG để tạo nên một pipeline hoàn chỉnh:
KHO TÀI LIỆU LỚN ──> RETRIEVAL (RAG) ──> NKTg AI (Giải mã AMP/DAMP & Core Content) ──> LLM ──> KẾT QUẢ CHÍNH XÁC 100%
- RAG đảm nhận việc quét diện rộng để tìm đúng tài liệu.
- NKTg AI đảm nhận việc bóc tách cấu trúc ngữ nghĩa, triệt tiêu ảo giác và khóa chặt tính nguyên bản của thông tin trước khi đưa qua LLM.
Trải nghiệm trực tiếp NKTg AI và các mô hình xử lý Local/Cloud tại: nktg.org